GTM Engineering: Was ein GTM Engineer macht – und wann du einen brauchst
Der GTM Engineer ist eine Rolle, nach der gerade viele B2B-Revenue-Teams fragen, obwohl sie kaum jemand einheitlich definiert. Gemeint ist die Person, die die Systeme zwischen Daten, Signalen, CRM und Sales baut. Hier steht, was die Rolle in der Praxis umfasst, wie sie sich von RevOps unterscheidet, wann du einstellen solltest und wann ein agentisches System den Großteil der Arbeit abdeckt.
 VonMario Maier
Veröffentlicht 20 Min. Lesezeit
Inhalt
- Warum plötzlich alle einen GTM Engineer suchen
- Was ist ein GTM Engineer, und woher kommt die Rolle?
- Was macht ein GTM Engineer konkret?
- GTM Engineer vs. RevOps, Marketing Ops, Sales Ops und Growth Engineer
- Welche Skills braucht ein GTM Engineer, und welchen Stack?
- Wie AI-Agenten die Rolle des GTM Engineers verändern
- Einstellen, extern bauen oder Agenten? Die Entscheidungsmatrix
- Was kostet ein GTM Engineer, und welche Risiken kaufst du mit ein?
- Beispiel: Die ersten 90 Tage mit GTM Engineer oder agentischem System
- Die häufigsten Fehler beim GTM Engineering
- Meine Empfehlung: GTM Engineer, Revenue Marketing Engineer und wo igromo passt
Warum plötzlich alle einen GTM Engineer suchen
Wenn ich mit Revenue-Teams über ihren Stack spreche, höre ich seit einiger Zeit eine Frage öfter als jede andere: „Brauchen wir einen GTM Engineer?“ Die Frage ist berechtigt. Der Stack ist gewachsen: CRM, Enrichment, Sequencer, Intent-Daten, ein Dutzend Automationen, dazu die ersten AI-Tools. Jedes Tool hat jemanden, der es eingeführt hat, nur ist niemand dafür verantwortlich, dass das Ganze als System funktioniert und am Ende Pipeline erzeugt.
Marketing Ops kümmert sich um Kampagnen und Automatisierung, Sales Ops um Territorien und Quoten, RevOps um Prozesse und Reporting. Dazwischen liegen die Übergänge: Wer bekommt den Lead? Welches Signal löst welches Play aus? Woher kommen die Daten, und wer prüft, ob sie stimmen? An diesen Übergängen entscheidet sich die Pipeline, und in vielen Teams gehören sie niemandem.
In diese Lücke stößt eine neue Rolle. Auf Deutsch gibt es dazu bisher kaum fundierte Inhalte, und die Rolle verändert sich schon wieder, bevor sie hier richtig angekommen ist. Anfangs ging es vor allem um Workflows. Mit AI-Agenten verschiebt sich die Arbeit vom Verkabeln einzelner Automationen hin zum Design eines Systems mit Knowledge Base, Rechten und Freigaben.
Ich gehe durch, was ein GTM Engineer konkret macht, wie er sich von RevOps & Co. unterscheidet, wann du einstellen solltest und wann ein externer Engineer oder Agenten reichen. Zum Schluss sage ich auch, wo ich selbst stehe, denn ich nenne mich AI-Native Revenue Marketing Engineer. Das ist nah dran, deckt sich aber nicht ganz.
Kurz vorweg: Ein Tool ist kein System.
Was ist ein GTM Engineer, und woher kommt die Rolle?
Ein GTM Engineer (Go-to-Market Engineer) baut und betreibt die technischen Systeme, mit denen ein Unternehmen Kunden findet, anspricht und an Sales übergibt: Datenflüsse, Enrichment, Signale, Routing, Automationen und zunehmend AI-Agenten. Der Unterschied zu klassischen Ops-Rollen liegt weniger im Werkzeugkasten als in der Haltung. Wer die Rolle ausfüllt, denkt wie ein Engineer: Revenue-Prozesse in Bausteine zerlegen, automatisieren, testen und messen, ob sie wirken.
Populär gemacht hat den Begriff Clay, der Anbieter der gleichnamigen Plattform für Enrichment und GTM-Workflows. In Clays eigenem Guide zur Rolle schreibt das Unternehmen, den Begriff 2023 geprägt zu haben. In der Ankündigung der Series-C-Finanzierung im August 2025 bezeichnete sich Clay als Pionier der Rolle, wie unter anderem Crunchbase News berichtete. Das ist die Darstellung eines Herstellers, der direkt von der Rolle profitiert. Eine unabhängige Quelle dafür, wer den Begriff zuerst verwendet hat, habe ich nicht gefunden.
Dass die Nachfrage wächst, lässt sich trotzdem zeigen, zumindest in Stellenanzeigen. Der Datenanbieter Bloomberry hat rund 1.000 Stellenanzeigen für GTM Engineering ausgewertet und berichtet für 2025 ein Plus von 205 % bei neuen Stellen gegenüber dem Vorjahr. eMarketer greift diese Zahl in einem FAQ auf. Zwei Einschränkungen würde ich mitdenken. Erstens ist die Basis klein: Dreistelliges Wachstum auf rund tausend Anzeigen zeigt einen Trend, von einem Massenmarkt ist das weit entfernt. Zweitens messen Stellenanzeigen die Nachfrage nach einem Titel, und was Unternehmen unter diesem Titel verstehen, geht weit auseinander.
Spannender finde ich eine andere Zahl aus derselben Auswertung: SQL und Python tauchen laut Bloomberry jeweils in 38 % der Anzeigen auf. Umgekehrt heißt das, dass in knapp zwei Dritteln der Anzeigen SQL nicht ausdrücklich verlangt wird. Die Rolle ist also breiter als ihr Name. Viele Unternehmen suchen unter diesem Titel jemanden, der Tools verbindet, Daten in Ordnung hält und Plays automatisiert. Ein Software-Entwickler muss das nicht zwingend sein.
Im deutschsprachigen Raum ist der Titel noch selten, die Arbeit selbst gibt es aber längst. Sie heißt hier Marketing Automation Manager, RevOps Engineer oder schlicht „die Person, die HubSpot wirklich versteht“. Ich arbeite mit dieser Definition: Ein GTM Engineer ist dafür verantwortlich, dass aus Daten und Signalen zuverlässig die richtige Aktion beim richtigen Menschen wird, und das muss sich in Pipeline messen lassen.
Was macht ein GTM Engineer konkret?
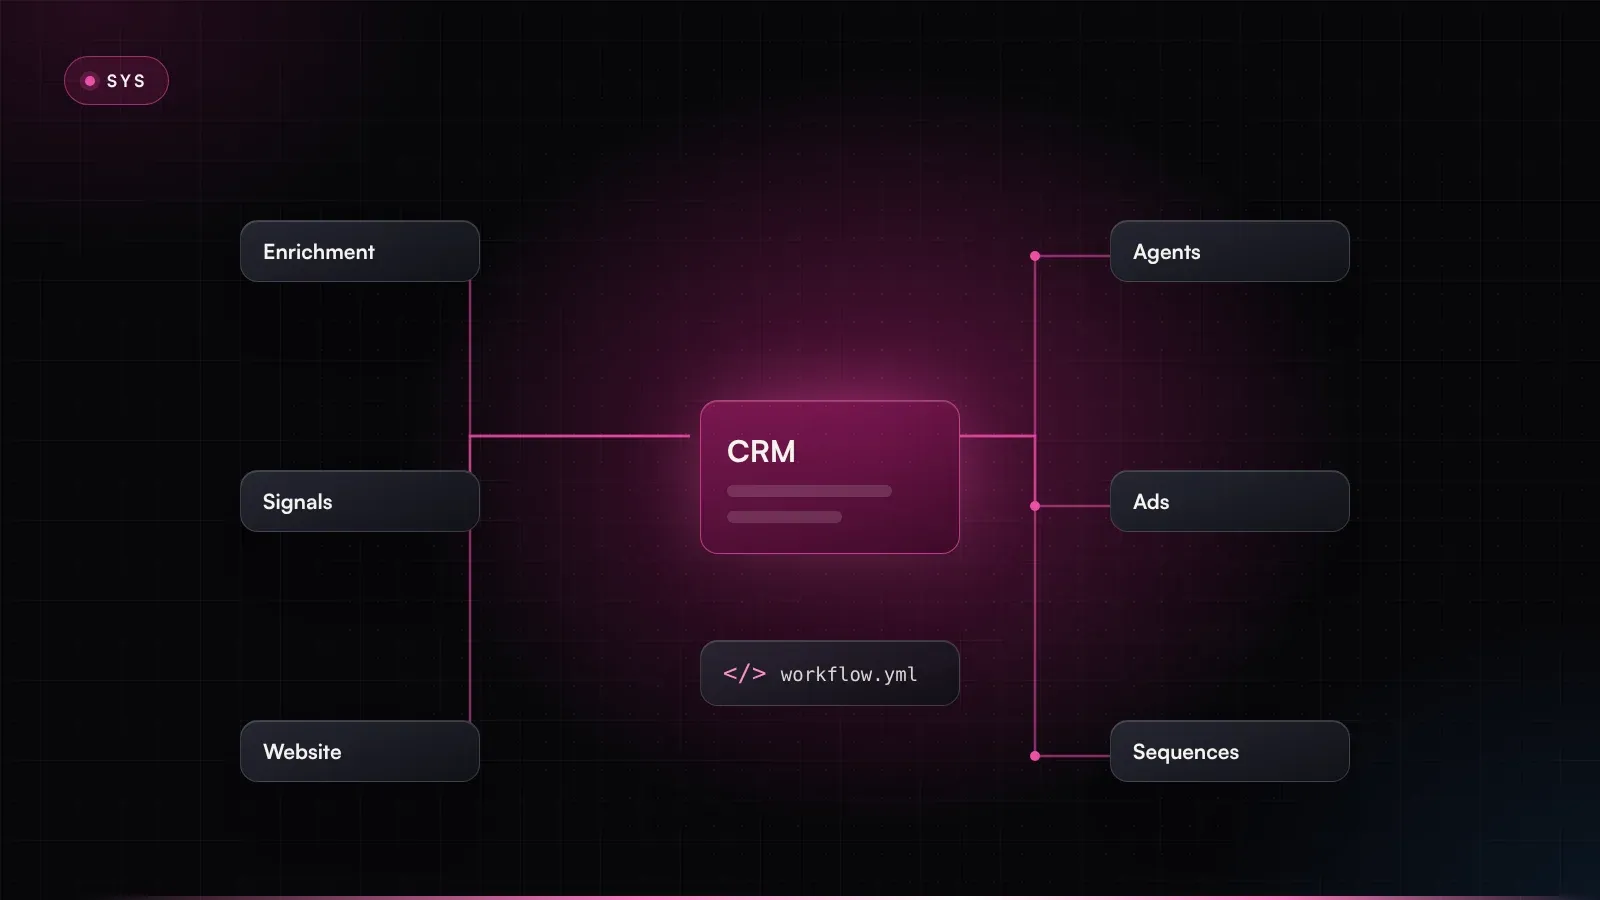
In Stellenanzeigen klingt die Rolle oft nach Tool-Bedienung: „Erfahrung mit Clay, HubSpot und Zapier“. In der Praxis sind es sechs Aufgabenfelder, die eng zusammenhängen. Wer nur eines davon beherrscht, baut Inseln.
- Daten & EnrichmentQuellen, Waterfall, Hygiene
- SignaleFit, Intent, Timing
- RoutingRichtiger Owner, schnell
- Workflows & PlaysVom Signal zur Aktion
- AI-AgentenRecherche, Entwürfe, Vorschläge
- CRM-ArchitekturObjekte, Felder, Stages
Wer nur eines der Felder beherrscht, baut Inseln. Das Ergebnis zählt erst, wenn aus Daten und Signalen Pipeline wird.
Daten und Enrichment
Die Grundlage jedes GTM-Systems sind Account- und Kontaktdaten, die vollständig, aktuell und konsistent sind. Dafür baut der Engineer Enrichment-Strecken, die mehrere Datenquellen nacheinander abfragen, bis ein Feld gefüllt ist (oft „Waterfall“ genannt), normalisiert Branchen, Länder und Firmengrößen und verhindert Dubletten. Außerdem dokumentiert er pro Datensatz Herkunft und Datum. Das wirkt pedantisch, hilft aber, unter der DSGVO nachzuweisen, woher personenbezogene Daten stammen.
Signale
Welche Ereignisse bedeuten, dass ein Account gerade jetzt relevant wird? Neue Stellen, ein Führungswechsel, eine Finanzierungsrunde, wiederholte Besuche auf der Pricing-Seite, Intent-Daten von Drittanbietern. Der Engineer macht diese Signale technisch verfügbar und verdichtet sie zu einer Priorität. Wie Fit, Intent und Timing dabei zusammenspielen, beschreibe ich ausführlich im Artikel zum Intent-Scoring mit Fit, Intent und Timing.
Routing
Ein Lead, der beim falschen Owner landet oder vier Stunden in einer Queue liegt, ist oft teurer als ein Lead, der nie kam. Routing-Logik entscheidet, wer einen Account oder Kontakt bekommt: nach Territorium, Segment, bestehendem Owner, Score und Kapazität. Dazu kommen Fallbacks für alles, was nicht eindeutig ist (und das ist mehr, als man beim ersten Entwurf denkt).
Workflows und Plays
Ein Play verbindet ein Signal mit einer Aktion. Besucht ein Account dreimal die Integrationsseite, wird er recherchiert, das passende Buying Center ergänzt, ein Entwurf geschrieben und eine Aufgabe für den Owner angelegt. Gebaut wird so etwas in Clay, in Automations-Tools wie n8n, Make oder Zapier, in HubSpot- oder Salesforce-Workflows oder mit eigenem Code.
AI-Agenten
Seit LLMs zuverlässig genug für Recherche, Klassifikation und Entwürfe sind, gehören Agenten zum Werkzeugkasten. Der Engineer entscheidet, welche Schritte ein Agent übernimmt, mit welchem Kontext er arbeitet und wie geprüft wird, ob das Ergebnis stimmt.
CRM-Architektur
Objekte, Felder, Lifecycle-Stages, Zuordnungen zwischen Kontakten, Accounts und Deals. Das ist das unspektakulärste der sechs Felder und das wichtigste. Jede Automation, jedes Reporting und jeder Agent baut auf diesem Datenmodell auf. Ist es schief, ist alles darüber schief.
Allen sechs Feldern gemeinsam ist der Anspruch: Wer die Rolle gut ausfüllt, hinterlässt Systeme, die auch ohne ihn weiterlaufen. Zumindest in der Theorie, dazu weiter unten mehr.
Wer die Rolle über Tools definiert, bekommt Tool-Bedienung. Ein GTM Engineer ist dafür verantwortlich, dass aus Daten Pipeline wird.
GTM Engineer vs. RevOps, Marketing Ops, Sales Ops und Growth Engineer
Nach der Abgrenzung werde ich am häufigsten gefragt, und in vielen Organigrammen ist sie ungeklärt. Die Rollen überschneiden sich, aber sie haben unterschiedliche Kernfragen und werden an unterschiedlichen Dingen gemessen.
| Rolle | Kernfrage | Typische Arbeit | Gemessen an | Typischer blinder Fleck |
|---|---|---|---|---|
| GTM Engineer | Wie wird aus Daten und Signalen automatisch die richtige Aktion? | Enrichment, Signale, Routing, Plays, Agenten | Pipeline aus Plays, Speed-to-Lead, gesparte Stunden | Dokumentation und Governance |
| RevOps | Funktioniert der Revenue-Prozess von Anfang bis Ende? | Prozesse, CRM-Ownership, Forecast, Reporting | Forecast-Qualität, Conversion, Datenqualität | Wenig Zeit für neue Plays |
| Marketing Ops | Laufen Kampagnen sauber und messbar? | Marketing Automation, Scoring, Formulare, Attribution | Kampagnen-Performance, MQLs, Datenhygiene | Endet oft an der Übergabe an Sales |
| Sales Ops | Kann Sales effizient verkaufen? | Territorien, Quoten, Vergütung, Sales-Tools | Produktivität, Zielerreichung | Sieht Marketing-Signale kaum |
| Growth Engineer | Wie wächst das Produkt selbst? | Experimente im Produkt, Onboarding, Self-Service-Funnel | Aktivierung, Conversion im Produkt | Selten für Buying Center im Sales-led gebaut |
Clay selbst formuliert die Grenze zu RevOps in seinem Guide so: RevOps hält die bestehende Motion am Laufen, GTM Engineering verändert, was die Motion ist. Ich finde die Unterscheidung hilfreich, für die Praxis aber zu glatt. In Teams mit 50 bis 200 Mitarbeitenden liegen RevOps und Systembau oft bei derselben Person, und die hat dann zwei Jobs, von denen der dringendere immer gewinnt. Meistens ist das der Forecast für den Board-Call. Das neue Play wartet.
Am häufigsten wird die Rolle mit dem Growth Engineer verwechselt. Der arbeitet in der Regel im Produkt: Onboarding, Aktivierung, Upgrade-Pfade in einem Self-Service-Modell. In sales-led SaaS mit großen Buying Centern liegt der Hebel woanders, nämlich vor dem Produkt: in Accounts, Rollen und Übergaben an Sales.
Ich mache es mir meistens so einfach: RevOps besitzt den Prozess, der GTM Engineer baut die Maschine darin, und Marketing besitzt die Botschaft, die durch die Maschine läuft. Fehlt eines davon, läuft die Maschine trotzdem weiter, nur eben in die falsche Richtung.
Welche Skills braucht ein GTM Engineer, und welchen Stack?
Wenn ich mir anschaue, woran GTM-Systeme in der Praxis scheitern, sind es selten fehlende Programmierkenntnisse. Häufiger fehlt das Verständnis dafür, wie ein Deal tatsächlich entsteht. Deshalb steht dieser Skill bei mir oben:
- Revenue-Verständnis: ICP, Buying Center, Deal-Stages, Sales Cycle. Wer nicht weiß, warum ein Account kauft, automatisiert die falschen Schritte.
- Datenmodellierung, also wie Kontakte, Accounts, Deals und Aktivitäten zusammenhängen. SQL hilft dabei, ist aber nicht der Kern.
- APIs und Integrationen: REST-Schnittstellen, Webhooks, Authentifizierung, Rate Limits. Ein Großteil der Arbeit besteht darin, Systeme zuverlässig miteinander sprechen zu lassen.
- Automation mit Workflows, die Fehler abfangen und melden. Still weitergereichte Fehler sind die teuersten.
- Der Umgang mit LLMs und Agenten: Kontext bereitstellen, Ausgaben strukturieren, Ergebnisse prüfen. Prompting ist der kleinste Teil davon.
- Dokumentation und Kommunikation, die gern unterschätzt werden. Dazu gehört, Specs zu schreiben, die andere verstehen, und mit Sales so zu reden, dass die Systeme dort auch genutzt werden.
Der Stack lässt sich in Schichten denken. Die Tools darin wechseln, die Schichten bleiben:
- 01GovernanceRechte-Leiter, Human Go, Change-Log
- 02Agenten & WorkflowsRecherche, Routing, Entwürfe
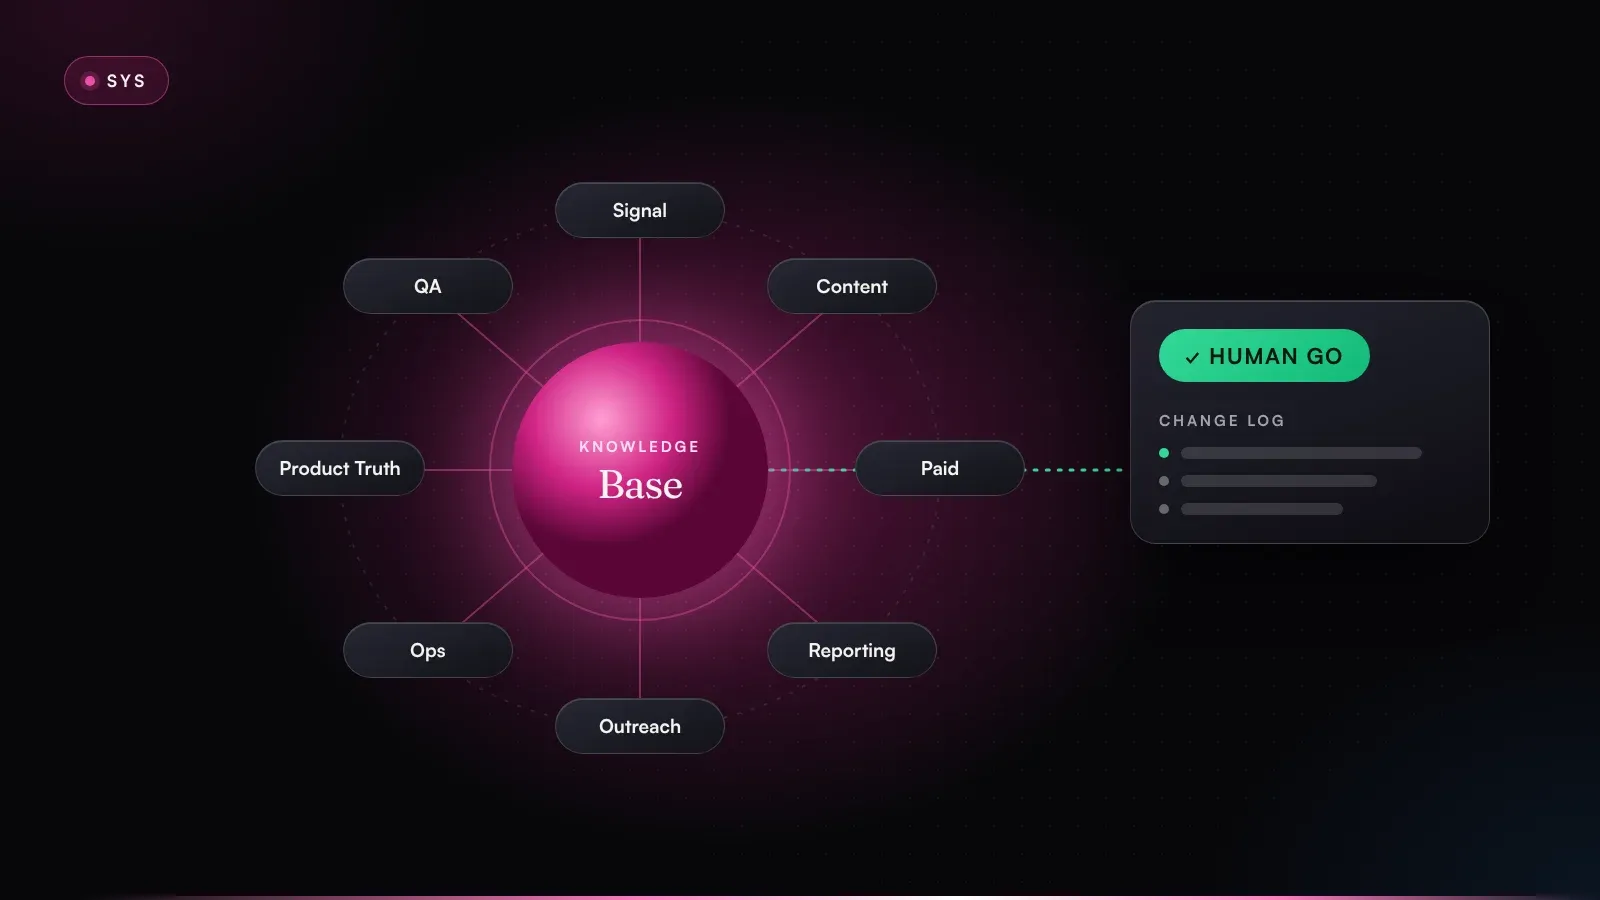
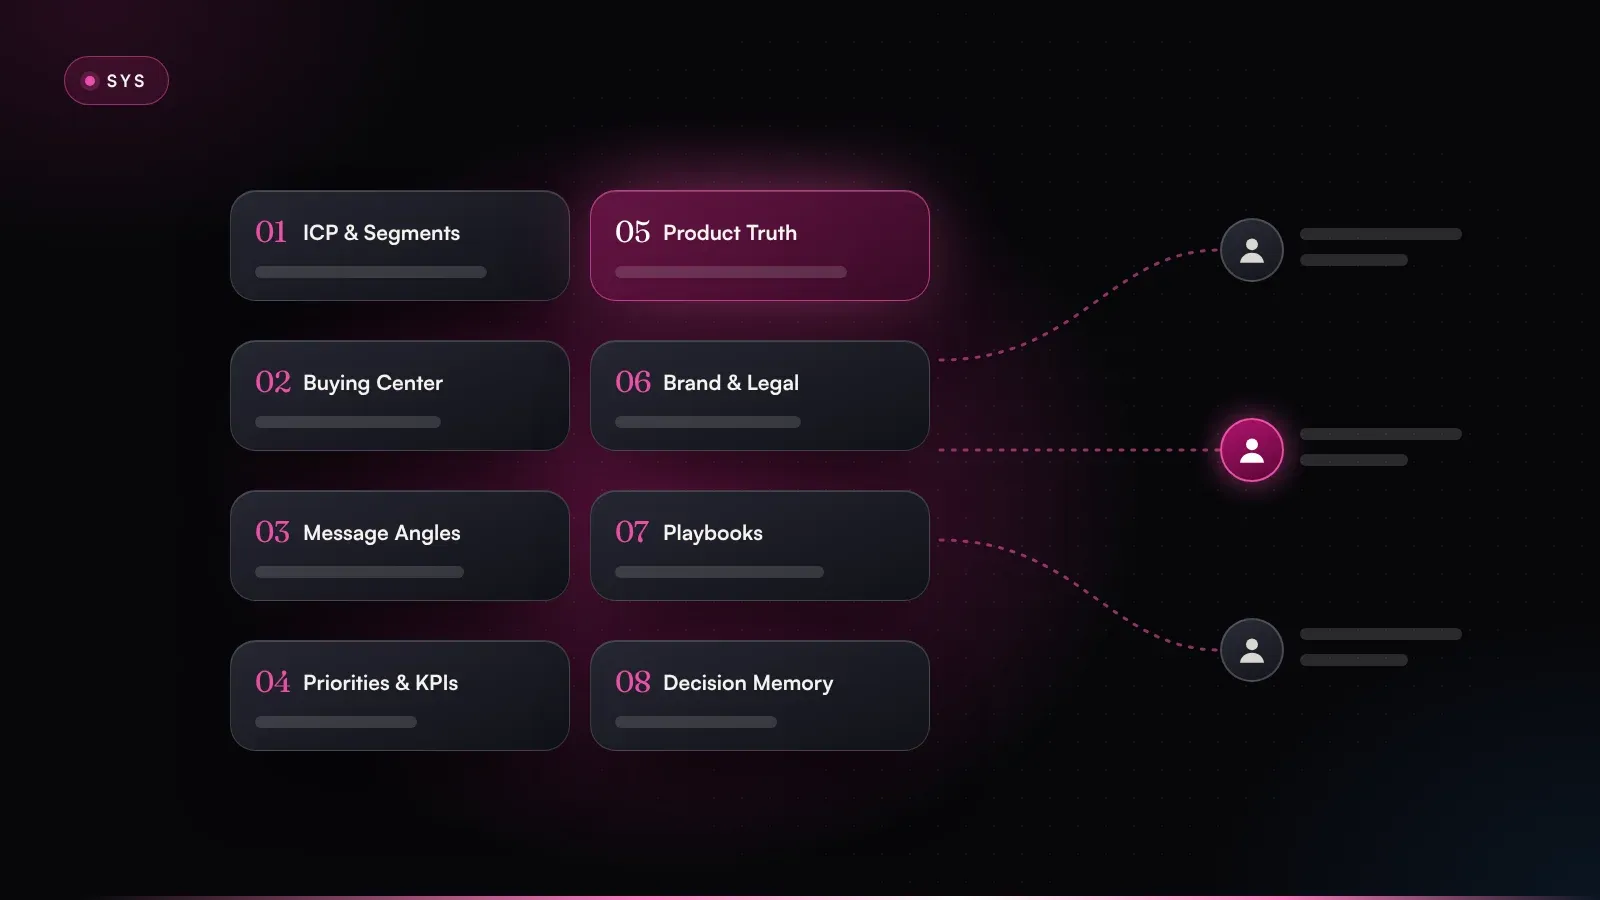
- 03Knowledge BaseICP, Buying Center, Angles, Regeln
- 04Daten & IntegrationEnrichment, APIs, Webhooks, MCP
- 05Systems of RecordCRM, Marketing Automation, Ads
Tools wechseln, Schichten bleiben. Jede Schicht braucht einen Owner – und Agenten arbeiten aus der Knowledge Base, nicht aus einzelnen Prompts.
Beispiele für Tools in diesen Schichten: ein CRM wie HubSpot oder Salesforce als System of Record, Clay für Enrichment und tabellenbasierte Workflows, n8n, Make oder Zapier für Automationen, ein Sequencer für Outreach, bei größeren Datenmengen ein Data Warehouse. Für Agenten kommen LLMs wie Claude über eine API dazu und zunehmend das Model Context Protocol (MCP), über das Agenten standardisiert auf Tools und Daten zugreifen. Welche Tools richtig sind, hängt von deinem Stack ab. Wichtiger ist, dass jede Schicht einen Owner hat.
Was einen guten Engineer von einem fleißigen unterscheidet, sieht man selten am Workflow selbst. Man sieht es an dem, was daneben liegt, nämlich an einer Spezifikation. So sieht eine aus, wie ich sie für jede produktive Automation erwarte:
Zweck:       Demo-Anfragen in < 10 Min. beim richtigen Owner
Trigger:     Formular „Demo“ oder Übergabe aus dem Chat
Inputs:      CRM-Kontakt, Enrichment (Größe, Branche, Land)
             Score aus Fit × Intent × Timing (0–100)
Logik:       1  Sperrliste oder Bestandskunde? → CSM, Stopp
             2  Account hat Owner?            → an Owner
             3  Score ≥ 70 und Tier 1/2       → AE-Round-Robin nach Region
             4  Score 40–69                   → SDR-Queue, Task 4 h
             5  Score < 40                    → Nurture, kein Task
Fallback:    Enrichment fehlt → Queue „manuell prüfen“, SLA 2 h
Rechte:      Routing = L3 · freigegebene Regel
             Nachricht an den Lead = L2 · nur nach Go
Owner:       RevOps Lead · Review: Head of Sales
Messung:     Speed-to-Lead, Fehlrouting-Quote, Meetings aus Inbound
Change-Log:  v3 Schwelle Tier 2 von 75 auf 70 (Go: Head of Sales)
             v2 Bestandskunden-Check ergänzt (Fehlrouting an SDRs)
So eine Spec ist Fleißarbeit, deshalb ist sie selten. Sie beantwortet die Fragen, die drei Monate später jemand stellen wird: Warum ist dieser Lead beim SDR gelandet? Wer hat die Schwelle geändert? Was passiert, wenn das Enrichment ausfällt? Ein Workflow ohne Spec funktioniert nur, solange die Person im Unternehmen ist, die ihn gebaut hat.
Wie AI-Agenten die Rolle des GTM Engineers verändern
Die erste Generation dieser Systeme bestand aus deterministischen Workflows: Wenn A passiert, tu B. Das ist stabil und gut prüfbar, aber starr. Jede neue Ausnahme ist ein neuer Zweig, jede Strategieänderung ein Umbau. Nach einem Jahr hat ein aktives Team Dutzende solcher Workflows, deren Logik verteilt in Clay-Tabellen, Zaps und CRM-Regeln steckt.
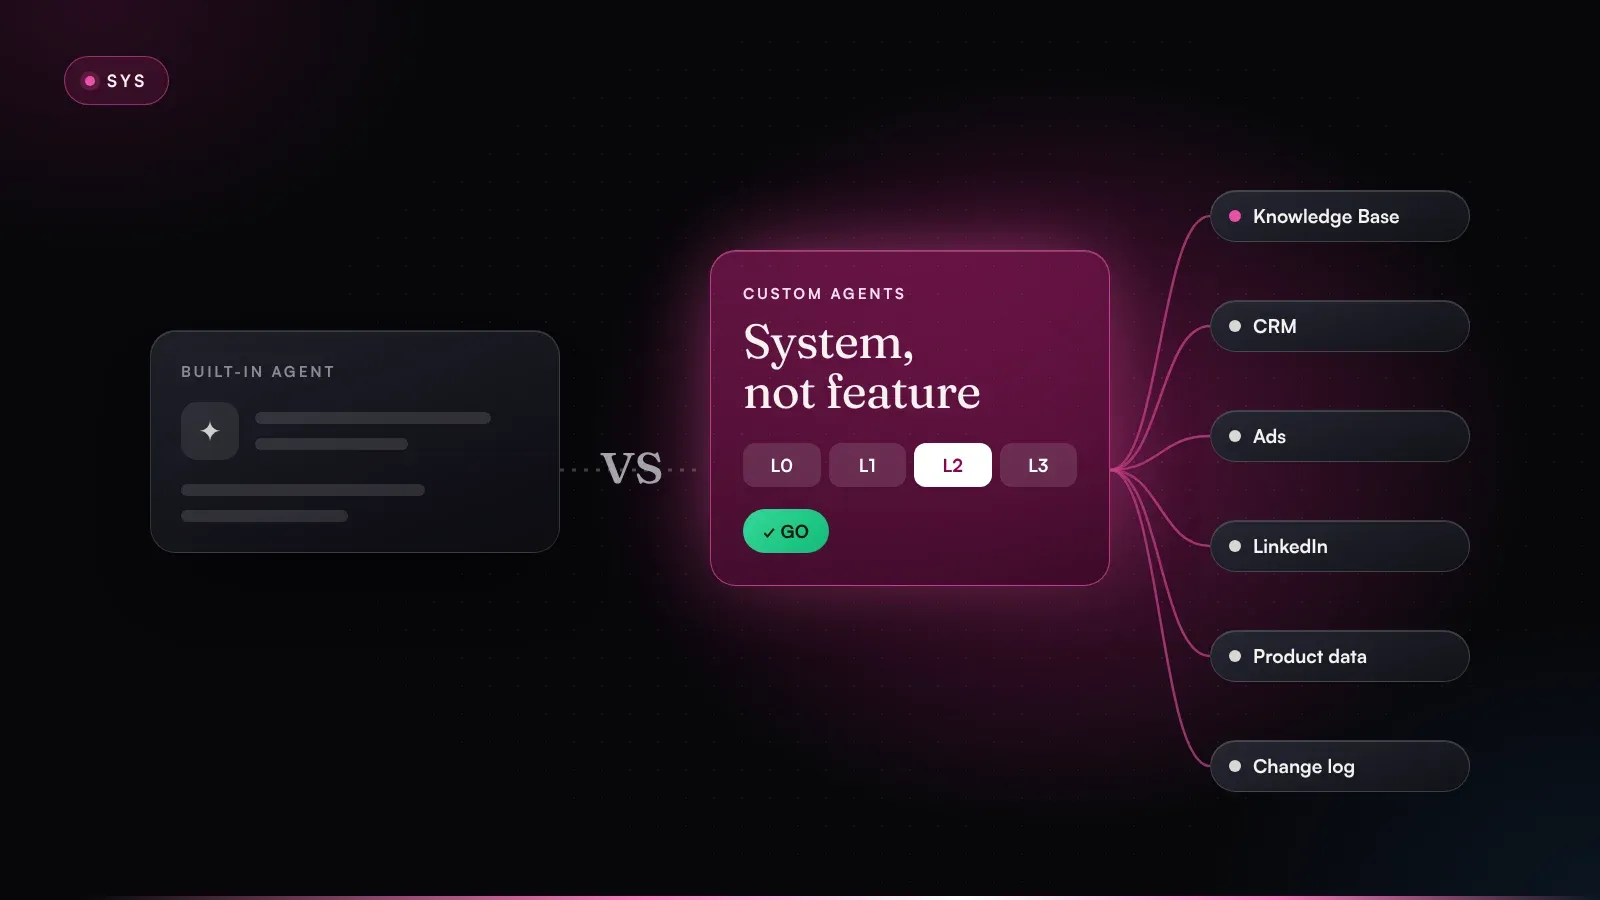
Agenten arbeiten anders. Sie treffen innerhalb eines Rahmens eigene Urteile: Ist dieser Account relevant? Welche Rolle fehlt im Buying Center? Welcher Message Angle passt? Das macht sie flexibler und verschiebt die Engineering-Arbeit. „Wie verkabele ich Schritt 4 mit Schritt 5?“ wird unwichtiger. Wichtiger wird, mit welchem Wissen der Agent arbeitet, was er darf und wer ihn prüft.
Workflow-Bauer
- Zaps und Clay-Tabellen verkabeln
- Logik steckt in jedem Workflow
- Jede Strategieänderung ist ein Umbau
- Wissen im Kopf des Engineers
System-Designer
- Regeln in einer Knowledge Base
- Agenten arbeiten aus derselben Quelle
- Rechte-Leiter L0–L3 und Human Go
- Change-Log statt Erinnerung
Mit Agenten verschiebt sich GTM Engineering: weniger Verkabelung, mehr Wissen, Rechte und Freigaben.
Daraus ergeben sich vier neue Kernaufgaben:
- Wissen gehört in eine Knowledge Base. ICP, Buying Center, Message Angles, freigegebene Claims und Routing-Regeln gehören in eine gemeinsame Knowledge Base, aus der alle Agenten arbeiten. Ändert sich die Strategie, passt du ein Modul an und musst nicht zwanzig Workflows anfassen. Wie so eine Wissensbasis aufgebaut ist, beschreibe ich im Artikel zur Marketing-Knowledge-Base für KI.
- Rechte pro Aufgabe. In RevPrime® arbeite ich mit einer Rechte-Leiter: L0 Lesen, L1 Vorschlagen, L2 Schreiben nach Go, L3 freigegebene Regel. Jeder Agent bekommt pro Aufgabe die Stufe, die er braucht, und keine höhere.
- Freigaben für alles mit Außenwirkung. Eine Nachricht an einen Kontakt, ein Budget, eine neue Audience: Das alles braucht ein Human Go. Interne Vorbereitung darf nach freigegebenen Regeln laufen.
- Ein Protokoll für jede Entscheidung. Jeder Vorschlag, jedes Go und jedes Nein landet mit Grund im Change-Log. Wiederkehrende Korrekturen werden zu Regeln in der Knowledge Base.
Die Arbeitsteilung wird dadurch eindeutiger. Agenten recherchieren Accounts, reichern Daten an, klassifizieren Signale, schreiben Entwürfe, schlagen Routing-Änderungen vor und bereiten Reports vor. Menschen entscheiden, welche Accounts Priorität haben, was an Kontakte rausgeht, welche Regeln gelten und wann sich der ICP ändert. Wie das im Detail abgesichert ist, steht unter Governance in RevPrime®.
Agenten machen die Arbeit. Menschen treffen die Entscheidungen. Der GTM Engineer der nächsten Jahre wird vor allem die Leitplanken dazwischen bauen, einzelne Automationen werden zur Nebensache.
In Projekten sehe ich immer wieder, dass Teams AI auf ihre bestehenden Workflows setzen und damit mehr von allem erzeugen: mehr Recherche, mehr Entwürfe, mehr Sequenzen, mehr Reports, die niemand liest. Output ↑. Pipeline →. AI ohne System produziert nur schneller das Falsche. Einen breiteren Überblick darüber, welche Agenten im B2B-Marketing Wirkung haben, gibt mein Guide zu KI-Agenten im B2B-Marketing.
Einstellen, extern bauen oder Agenten? Die Entscheidungsmatrix
„GTM Engineer ja oder nein“ greift meistens zu kurz. Interessanter ist, welche Form von GTM-Systemarbeit du gerade brauchst und wie viel davon. Das hängt an zwei Faktoren. Erstens daran, wie reif deine Revenue-Logik ist: Sind ICP, Buying Center, Prioritäten und Übergaben an Sales festgelegt und dokumentiert? Zweitens daran, wie viel laufende Systemarbeit anfällt, also neue Plays, Experimente, Integrationen und Datenpflege.
Zwei Fragen entscheiden: Wie reif ist deine Revenue-Logik – und wie viel GTM-Systemarbeit fällt laufend an?
| Ausgangslage | Meine Empfehlung | Warum |
|---|---|---|
| Kein klarer ICP, Revenue-Logik nur in Köpfen | Noch niemanden einstellen, erst Diagnose und Logik | Ein Engineer automatisiert sonst Annahmen, die sich in drei Monaten ändern |
| Logik unklar, aber Stack und Leads wachsen schnell | Externer Engineer für den Aufbau (Build) | Fundament und System zuerst, danach weißt du, welche Rolle du brauchst |
| Tool-Zoo, viel Aktivität, wenig Pipeline | Externe Reparatur (Repair), dann entscheiden | Erst zurück an Pipeline koppeln, dann skalieren |
| Logik steht, wiederkehrende Aufgaben in Recherche, Routing, Reporting | Zwei bis drei Agenten mit internem Owner | Die Arbeit ist klar genug, ein voller Headcount wäre unterausgelastet |
| Logik steht, viele Plays, tägliche Experimente, mehrere Segmente | GTM Engineer inhouse einstellen | Es gibt genug Systemarbeit für eine Vollzeitrolle und jemanden, der sie führt |
| Ein einzelnes großes Integrationsprojekt | Zeitlich begrenztes Projekt, kein Hire | Nach dem Projekt fehlt die Arbeit für eine feste Stelle |
An der Tabelle fallen mir zwei Dinge auf. Die Frage nach der Einstellung kommt erst, wenn die Revenue-Logik steht, und das ist Absicht: Wer ohne klaren ICP ins Unternehmen kommt, wird zum Strategen wider Willen oder baut, was ihm am lautesten zugerufen wird. Außerdem verändern Agenten die Rechnung, ohne die Rolle überflüssig zu machen. Wenn sie Recherche, Routing und Reporting übernehmen, brauchst du oft keine zusätzliche Vollzeitstelle. Du brauchst einen Owner, der das System führt, und das kann eine RevOps-Person sein, die dafür Zeit bekommt.
Bevor du eine Stelle ausschreibst, geh diese Punkte durch, ohne dir etwas schönzureden:
- ICP mit Ausschlusskriterien ist so dokumentiert, dass ihn auch jemand außer dem Gründer erklären kann
- Das Buying Center deiner typischen Deals ist beschrieben, mit Rollen, Einwänden und Proof
- Es gibt eine schriftliche Definition, wann ein Lead oder Account an Sales übergeben wird
- Das CRM ist das System of Record, konkurrierende Wahrheiten in Tabellen gibt es nicht
- Du kannst mindestens fünf konkrete Plays benennen, die die Person bauen soll
- Es gibt jemanden, an den die Rolle berichtet und der Revenue-Verantwortung trägt
- Du weißt, woran du die Person nach 90 Tagen misst, und die Antwort lautet Pipeline
Was kostet ein GTM Engineer, und welche Risiken kaufst du mit ein?
Belastbare Gehaltszahlen für diese Rolle im deutschsprachigen Raum habe ich nicht gefunden, und ich erfinde keine. Die einzige systematische Quelle, die ich kenne, ist die erwähnte Bloomberry-Auswertung. Sie nennt einen Median der ausgeschriebenen Gehälter von rund 127.500 US-Dollar. Der Wert stammt aus Stellenanzeigen, nicht aus tatsächlichen Verträgen, und lässt sich nicht direkt auf DACH übertragen. Als Orientierung taugt er trotzdem: Gesucht wird ein Senior-Profil, das Revenue-Verständnis, Datenkompetenz und Engineering verbindet. Solche Menschen sind nicht günstig.
Das Gehalt ist allerdings nur ein Teil der Rechnung. Enrichment-Plattformen und Datenanbieter rechnen oft nach Credits oder Volumen ab, LLM-Nutzung nach Tokens. Diese Kosten wachsen mit jedem neuen Play mit, und das fällt oft erst auf, wenn die Rechnung kommt. Dazu kommt die Einarbeitung: Auch ein erfahrener Engineer braucht Wochen, bis er Produkt, Markt, Stack und die ungeschriebenen Regeln deines Vertriebs verstanden hat.
Unterschätzt wird meistens die Wartung. APIs ändern sich, Felder werden umbenannt, Anbieter drehen an ihren Preismodellen, und nach dem ersten Jahr ist ein großer Teil der Arbeit Pflege. Bleibt die Abstimmung: Jedes neue Play betrifft Sales, und ohne Zeit dafür baut der Engineer an Sales vorbei.
Dann gibt es Risiken, die in keinem Budget stehen. Das größte ist der Single Point of Failure: Eine Person baut in einem Jahr ein System, das außer ihr niemand versteht. Kündigt sie, geht mit ihr auch die Logik hinter Routing, Scoring und Datenflüssen. Fast genauso heikel sind Schattensysteme, also Logik, die in Clay-Tabellen oder privaten Automations-Accounts lebt und im CRM nirgends auftaucht. Das dritte Risiko betrifft den Datenschutz. Wer automatisiert Kontaktdaten anreichert und Menschen anspricht, braucht eine Rechtsgrundlage, dokumentierte Quellen und einen Prozess für Widersprüche. Das klärst du mit den Verantwortlichen für Datenschutz, bevor du startest.
Ein System, das nur eine Person versteht, ist kein System. Es ist ein Risiko mit Gehalt.
Beispiel: Die ersten 90 Tage mit GTM Engineer oder agentischem System
Ein durchgespieltes, fiktives Beispiel macht die Entscheidung greifbarer. Angenommen, ein Scale-up verkauft eine SaaS-Lösung für Instandhaltungsplanung an Industrieunternehmen. Rund 80 Mitarbeitende, Series B, sechs Account Executives, vier SDRs, zwei Personen im Marketing und eine RevOps-Managerin. Das CRM ist HubSpot, dazu ein Sequencer und ein Clay-Account, den ein SDR vor einem Jahr eingerichtet hat. Die Symptome kennt man: Inbound-Leads landen oft beim falschen Owner, Outbound läuft über eine einzige Sequenz für alle, und niemand kann sagen, welche Aktivität zu Pipeline führt.
Variante A: Ein GTM Engineer wird eingestellt
Die ersten drei Wochen gehen in Einarbeitung und Bestandsaufnahme: Datenmodell, Felder, bestehende Workflows, Gespräche mit Sales. Der neue Engineer findet Dubletten, verwaiste Felder und drei Routing-Regeln, die sich widersprechen. In den Wochen vier bis acht baut er eine Enrichment-Strecke, repariert das Inbound-Routing und setzt die ersten signalbasierten Plays auf, etwa für Accounts, die Stellen in der Instandhaltung ausschreiben. In den Wochen neun bis zwölf kommen die ersten AI-Workflows für Account-Recherche dazu.
Nach 90 Tagen läuft vieles besser, zwei Dinge sind allerdings offen geblieben. Welche Segmente Priorität haben, welche Rollen im Buying Center angesprochen werden und welche Botschaft für wen gilt, hat der Engineer nebenbei aus Gesprächen abgeleitet. Aufgeschrieben ist diese Revenue-Logik nirgends, sie steckt in seinen Workflows. Dokumentiert ist außerdem nur, was er selbst für wichtig hielt.
Variante B: Ein agentisches System wird aufgebaut
In Variante B beginnt die Arbeit bei der Revenue-Logik, der Stack kommt später. Die ersten zwei Wochen gehören der Diagnose und der Knowledge Base: ICP mit Ausschlusskriterien, Buying Center, Message Angles, Prioritäten und Routing-Regeln, gemeinsam mit Sales und Marketing festgelegt. In den Wochen drei und vier werden CRM, Clay und Web angebunden, lesend für die Analyse und schreibend nur für freigegebene Aktionen. Ab Woche fünf gehen die ersten drei Agenten live: ein Signal Agent für die Priorisierung, ein Outreach Routing Agent für die korrekte Zuordnung und ein Pipeline Reporting Agent für das wöchentliche Review. Alles mit Human Go und Change-Log.
- Tag 1–14Diagnose & LogikICP, Buying Center, Prioritäten
- Tag 15–30Daten & AnbindungCRM, Enrichment, Web
- Tag 31–60Erste AgentenSignal, Routing, Reporting
- Tag 61–90Rhythmus & ÜbergabeWöchentliches Review, Change-Log, Owner
Variante B aus dem Beispiel: erst Revenue-Logik und Knowledge Base, dann Daten, dann Agenten mit Human Go – und am Ende ein interner Owner.
Ab Woche neun geht es um den Rhythmus: tägliche Vorschläge, ein wöchentliches Pipeline-Review, und die RevOps-Managerin übernimmt das System als Owner. Programmieren muss sie dafür nicht können. Sie braucht Zeit und eine eindeutige Verantwortung.
| Dimension | A: GTM Engineer eingestellt | B: Agentisches System |
|---|---|---|
| Startpunkt | Stack und Daten | Revenue-Logik und Knowledge Base |
| Nach 90 Tagen vorhanden | Saubere Daten, Routing, erste Plays | Knowledge Base, drei Agenten, Rhythmus, Owner |
| Wo steckt die Logik? | In Workflows und im Kopf des Engineers | In der Knowledge Base, für alle lesbar |
| Dokumentation | So gut wie die Disziplin der Person | Teil des Systems: Specs, Change-Log, Entscheidungsgedächtnis |
| Abhängigkeit | Hoch von einer Person | Vom System und seinem internen Owner |
| Stärke | Tiefe, Geschwindigkeit bei neuen Experimenten | Konsistenz, Governance, Übergabefähigkeit |
| Schwäche | Strategie entsteht nebenbei | Neue Experimente brauchen später jemanden, der baut |
Ehrlich gesagt ist keine der beiden Varianten per se besser. Die beste Reihenfolge ist in meiner Erfahrung oft eine Kombination: erst Revenue-Logik und System, dann ein GTM Engineer, der darauf aufbaut. Diese Person findet eine Knowledge Base, dokumentierte Regeln und laufende Agenten vor und kann ab Woche eins neue Plays bauen. Altlasten muss sie kaum aufräumen.
Was du nach 90 Tagen misst
Egal, welche Variante du wählst: Miss das Ergebnis nicht an der Zahl gebauter Workflows. Diese Kennzahlen sagen mehr:
- Speed-to-Lead: Zeit zwischen Anfrage und erstem Kontakt durch den richtigen Owner.
- Fehlrouting-Quote: Anteil der Leads und Accounts, die manuell umgehängt werden müssen.
- Datenabdeckung: Anteil der Tier-1-Accounts mit vollständigen Pflichtfeldern und dokumentierter Quelle.
- Korrekturquote: Anteil der Agenten-Vorschläge, die vor dem Go geändert werden. Bleibt sie hoch, fehlen Regeln.
- Pipeline aus Plays: Opportunities und Pipeline-Wert, die auf ein Signal oder einen Play zurückgehen.
- Dokumentationsgrad: Anteil der produktiven Automationen mit Spec, Owner und Change-Log.
Die häufigsten Fehler beim GTM Engineering
Tool zuerst
Ein Team kauft Clay, einen Intent-Anbieter und ein AI-SDR-Tool und sucht dann jemanden, der „das alles zum Laufen bringt“. Damit ist die Architektur entschieden, bevor jemand gefragt hat, welches Problem sie lösen soll. Methode vor Tool: Erst die Revenue-Logik, dann die Werkzeuge, die sie umsetzen.
Keine Revenue-Logik
Automationen ohne klaren ICP, ohne Buying-Center-Modell und ohne definierte Übergaben an Sales skalieren Annahmen. Der Engineer baut dann sehr effizient Prozesse für Accounts, die nie kaufen.
Keine Dokumentation
„Das steht im Workflow“ ist keine Dokumentation. Jede produktive Automation braucht eine Spec, einen Owner und ein Change-Log. Das kostet pro Workflow vielleicht eine Stunde und spart später Tage.
Single Point of Failure
Wenn eine Person das ganze GTM-System gebaut hat und als einzige versteht, ist das Unternehmen verwundbar, spätestens an dem Tag, an dem diese Person krank ist oder kündigt. Mindestens eine zweite Person muss das System lesen und in Grundzügen bedienen können.
Gebaute Workflows als Erfolgsmaßstab
Zwanzig neue Automationen klingen nach Fortschritt. Aktivität ist nicht Wirkung. Pipeline ist Wirkung. Wer an der Zahl seiner Builds gemessen wird, liefert viele Builds.
Agenten ohne Governance
Der jüngste Fehler sind Agenten mit Schreibrechten im CRM oder Sequencer, die ohne Rechte-Leiter, Freigaben und Protokoll arbeiten. Das geht so lange gut, bis ein Agent hundert Kontakte mit der falschen Botschaft anschreibt.
Meine Empfehlung: GTM Engineer, Revenue Marketing Engineer und wo igromo passt
Ich werde oft gefragt, ob ich GTM Engineer bin. Zum Teil, würde ich sagen. Ich nenne mich AI-Native Revenue Marketing Engineer, und jedes der drei Wörter ist bewusst gewählt.
Die Überschneidung ist groß. Wie ein GTM Engineer baue ich, statt zu empfehlen: Ich verbinde CRM, Ads, Daten und Web, schreibe die Agenten, definiere Routing und Signale und übergebe ein System, das läuft. Ich denke in Datenflüssen, Specs und Fehlerfällen. Wer mich bei der Arbeit sieht, würde mir wahrscheinlich diesen Titel geben.
Der Unterschied liegt im Startpunkt und im Maßstab. Ich komme aus über 15 Jahren B2B Revenue Marketing. Bevor ich etwas baue, will ich wissen, an wen du verkaufst, wer im Buying Center mitentscheidet und welche Botschaft für welche Rolle trägt. Die Revenue-Logik ist bei mir kein Nebenprodukt der Workflows, sondern ihre Voraussetzung. AI-Native heißt für mich, dass Agenten Teil der Architektur sind, kein Add-on. Gemessen wird alles an Pipeline und Revenue. Wie viele Automationen ich gebaut habe, interessiert am Ende niemanden.
Der zweite Unterschied: Ich will nicht dauerhaft der Mensch sein, ohne den dein System nicht läuft. Ein GTM Engineer gehört im Idealfall fest zu deinem Team. Ich baue ein System und übergebe es dokumentiert, damit dein Team es führen kann. Im Zentrum steht die Knowledge Base, dazu kommen acht Kern-Agenten plus die eigenen, die dein Geschäft braucht, die Rechte-Leiter, Human Go und Change-Log. Das Ganze läuft in deinen Tools, eine Parallelwelt baue ich nicht.
Daraus ergeben sich die zwei Wege, auf denen ich arbeite. Bei Build baue ich Marketing von Anfang an als agentisches System auf: Revenue-Logik und Knowledge Base ab Tag eins, Hub und Datenanbindung ab Woche drei, die ersten Agenten ab Woche fünf. Das passt, wenn du gerade überlegst, ob dein erster Hire diese Rolle sein soll. Bei Repair kopple ich ein bestehendes Setup zurück an Pipeline und docke Agenten dort an, wo dein Team heute Zeit verbrennt. Das ist der richtige Weg, wenn du schon einen Tool-Zoo hast und nicht mehr sagen kannst, was davon wirkt.
Wenn du jemanden brauchst, der jeden Tag neue Outbound-Experimente baut und Clay-Tabellen debuggt, stell einen GTM Engineer ein. Ich bin nicht dieser Mensch, und ich will es auch nicht sein. Was ich tun kann: dafür sorgen, dass er ein System vorfindet, auf dem er aufbauen kann, ohne es vorher reparieren zu müssen. Mehr dazu, wie ich arbeite, steht auf meiner Seite Über igromo.
Meine konkrete Empfehlung in vier Schritten:
- Revenue-Logik aufschreiben. ICP, Buying Center, Message Angles, Übergaben an Sales. Wenn das nicht geht, hast du dein eigentliches Problem gefunden, und ein Engineer würde es nicht lösen.
- Systemarbeit inventarisieren. Liste alle wiederkehrenden Aufgaben in Daten, Signalen, Routing und Reporting auf und markiere, welche klar genug für Agenten sind.
- Mit zwei, drei Agenten starten. Die mit dem größten Pipeline-Hebel, mit Human Go und einem internen Owner.
- Nach 90 Tagen über die Rolle entscheiden. Wenn die Arbeit für neue Plays dann eine Vollzeitstelle füllt, stell ein. Die Person findet dann ein System vor, in das sie sich einarbeiten kann.
Wenn du wissen willst, wo du in der Matrix stehst: Im kostenlosen 30-minütigen Diagnose-Call schauen wir uns deinen Stack und deine Revenue-Logik an und klären, ob Build, Repair oder ein eigener GTM Engineer der bessere nächste Schritt ist. Kein Pitch.
Häufige Fragen
Was macht ein GTM Engineer?
Ein GTM Engineer baut und betreibt die technischen Systeme, mit denen ein Unternehmen Kunden findet, anspricht und an Sales übergibt. Dazu gehören Enrichment und Datenqualität, Signale, Routing, automatisierte Plays, AI-Agenten und die Architektur des CRM. Gemessen werden sollte die Rolle an Pipeline. Die Zahl gebauter Workflows sagt wenig.
Was ist der Unterschied zwischen GTM Engineer und RevOps?
RevOps verantwortet den Revenue-Prozess als Ganzes: CRM-Ownership, Forecast, Reporting und die Übergaben zwischen Marketing, Sales und Customer Success. Der GTM Engineer baut die Systeme innerhalb dieses Prozesses, vor allem neue Plays, Datenflüsse und Automationen. In kleineren Teams übernimmt oft eine Person beide Rollen.
Welche Skills braucht ein GTM Engineer?
Am wichtigsten ist Revenue-Verständnis: ICP, Buying Center, Deal-Stages und Sales Cycle. Dazu kommen Datenmodellierung, APIs und Integrationen, Automations-Tools sowie der Umgang mit LLMs und Agenten. SQL oder Python helfen, werden laut einer Auswertung von Bloomberry aber nur in einem Teil der Stellenanzeigen ausdrücklich verlangt.
Ab wann lohnt es sich, einen GTM Engineer einzustellen?
Sobald die Revenue-Logik dokumentiert ist und genug laufende Systemarbeit für eine Vollzeitstelle anfällt, etwa durch viele Plays, mehrere Segmente und regelmäßige Experimente. Fehlt die Revenue-Logik noch, automatisiert ein GTM Engineer vor allem Annahmen, und dann ist ein externer Aufbau oder ein agentisches System mit internem Owner meist der bessere erste Schritt.
Was verdient ein GTM Engineer?
Für den deutschsprachigen Raum gibt es bisher kaum belastbare Gehaltsdaten zu dieser Rolle. Eine Auswertung von Stellenanzeigen durch Bloomberry nennt einen Median der ausgeschriebenen Gehälter von rund 127.500 US-Dollar. Dieser Wert stammt aus Stellenanzeigen, nicht aus Verträgen, und ist nicht direkt auf DACH übertragbar. Sicher ist nur, dass ein Senior-Profil gesucht wird und zum Gehalt noch Tool-, Daten- und Wartungskosten kommen.
Ersetzen AI-Agenten den GTM Engineer?
Eher nicht. Sie verändern die Rolle. Agenten übernehmen wiederkehrende Arbeit wie Recherche, Enrichment, Klassifikation, Entwürfe und Reporting. Der Schwerpunkt verlagert sich vom Bauen einzelner Workflows zum Design des Systems: Knowledge Base, Rechte, Freigaben und Protokoll.

Über den Autor
Mario Maier
AI-Native Revenue Marketing Engineer · Founder von igromo
Seit über 15 Jahren arbeite ich an der Schnittstelle von Marketing, Sales und Revenue Operations, vom Early-Stage-Setup bis zu Scale-ups mit mehrstufigen Sales Cycles und großen Buying Centern. Seit 2019 messe ich meine Arbeit an Pipeline und Revenue.
Wo stehst du?
Der Agentic Readiness Check zeigt in 3 Minuten, wie bereit dein Marketing für Agenten ist – und welche Lücken du zuerst schließt.
Weiterlesen
Alle InsightsSYS22 Min. Lesezeit
KI-Agenten im B2B-Marketing: der Leitfaden vom ersten Prompt zur Pipeline
KI-Agenten im Marketing, die Pipeline bewegen: Definition, Architektur, die 8 Kern-Agenten mit Workflows, Grenzen, KPIs und ein 90-Tage-Plan für B2B.
SYS19 Min. Lesezeit
Marketing Knowledge Base für KI aufbauen: 8 Module, klare Regeln und eine Vorlage
Knowledge Base für KI im B2B-Marketing aufbauen: 8 Module mit Owner und Vorlage, was in den Prompt gehört und was nicht, Governance und ein 4-Wochen-Plan.
SYS17 Min. Lesezeit
HubSpot Breeze Agents vs. eigene AI-Agenten: Was reicht wann?
HubSpot Breeze Agents oder eigene AI-Agenten? Meine Einschätzung zum Produktstand 2026: wo Breeze reicht, wo nicht – mit Matrix, Test-Checkliste und Plan.